Giriş
Bir dil modeli; politikalarınızı, ürün ayrıntılarınızı, fiyatlandırma kurallarınızı, hizmet geçmişinizi veya şirket içi sürecinizi bilmese bile kendinden emin bir yanıt yazabilir. Bu, genel yazım için faydalıdır; ancak bir müşteri, çalışan veya ekip üyesi gerçek belgelerinize dayanan bir yanıt beklediğinde risklidir.
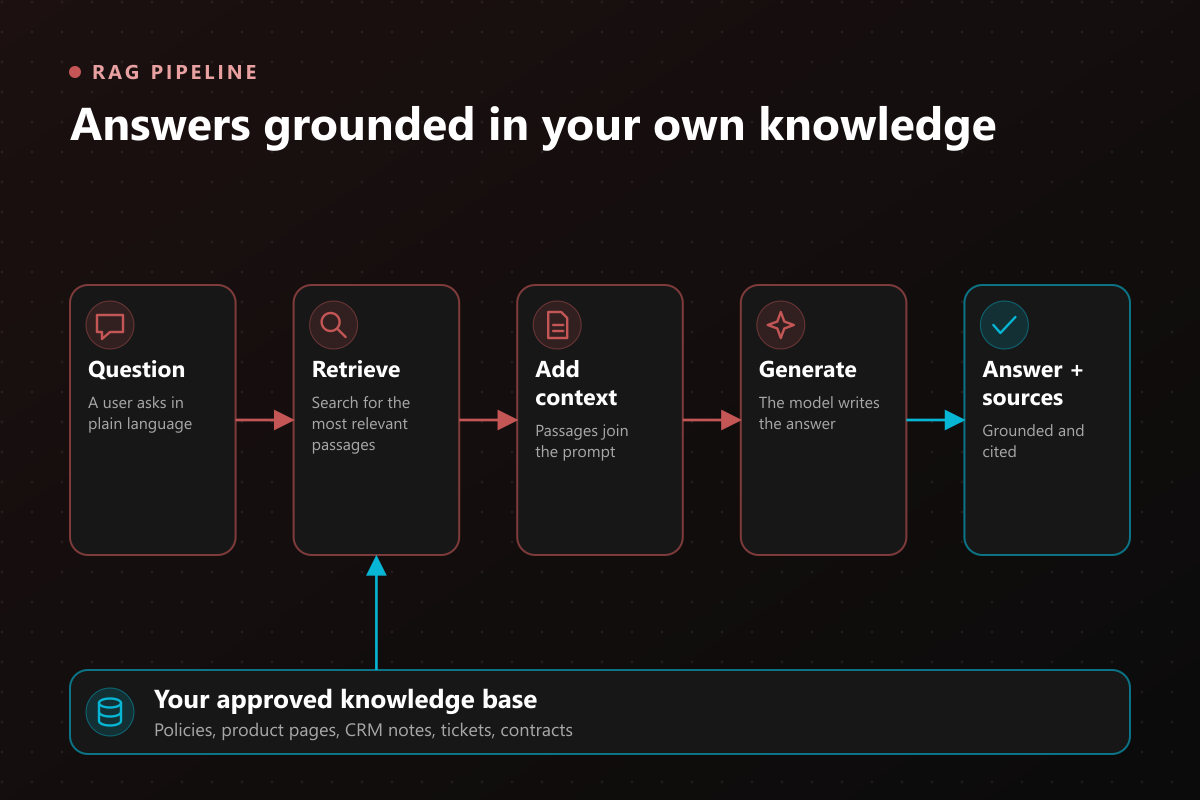
Genellikle RAG olarak adlandırılan geri getirme destekli üretim (retrieval-augmented generation), bu açığı kapatır. Model yanıt vermeden önce sistem onaylı bilgi tabanınızda arama yapar, en alakalı pasajları getirir ve bu pasajları prompt'a iletir. Böylece yanıt, yalnızca modelin hafızasıyla değil, işletmenizin kontrol ettiği materyalle şekillenir.
Bu önemlidir, çünkü iş bilgisinin çoğu durağan değildir. Politikalar değişir. Ürün sayfaları güncellenir. Müşteri notları CRM'de durur. Destek çözümleri kılavuzlarda yer almadan önce taleplerde ortaya çıkar. Bir RAG pipeline'ı, yapay zekaya bir modeli her hafta yeniden eğitmeden bu değişen bilgiyi kullanma imkanı verir.
RAG pipeline'ı nedir?
RAG pipeline'ı, iş bilgisini bir yapay zeka sistemi için aranabilir bağlama dönüştüren adımlar bütünüdür. Genellikle iki büyük yarısı vardır: veri alımı (ingestion) ve geri getirme (retrieval).
Veri alımı, kaynak materyali hazırlar. Belgeleri, sayfaları, elektronik tabloları, talepleri, transkriptleri ve veritabanı kayıtlarını okur. Bunları anlamlı bölümlere ayırır, metadata ekler, bölümleri embedding'lere dönüştürür ve bir arama katmanında saklar.
Geri getirme, kullanıcı bir soru sorduğunda gerçekleşir. Sistem soruyu anlar, en alakalı bölümleri arar, izinlere ve metadata'ya göre filtreler ve modele yalnızca kullanması gereken parçaları verir.
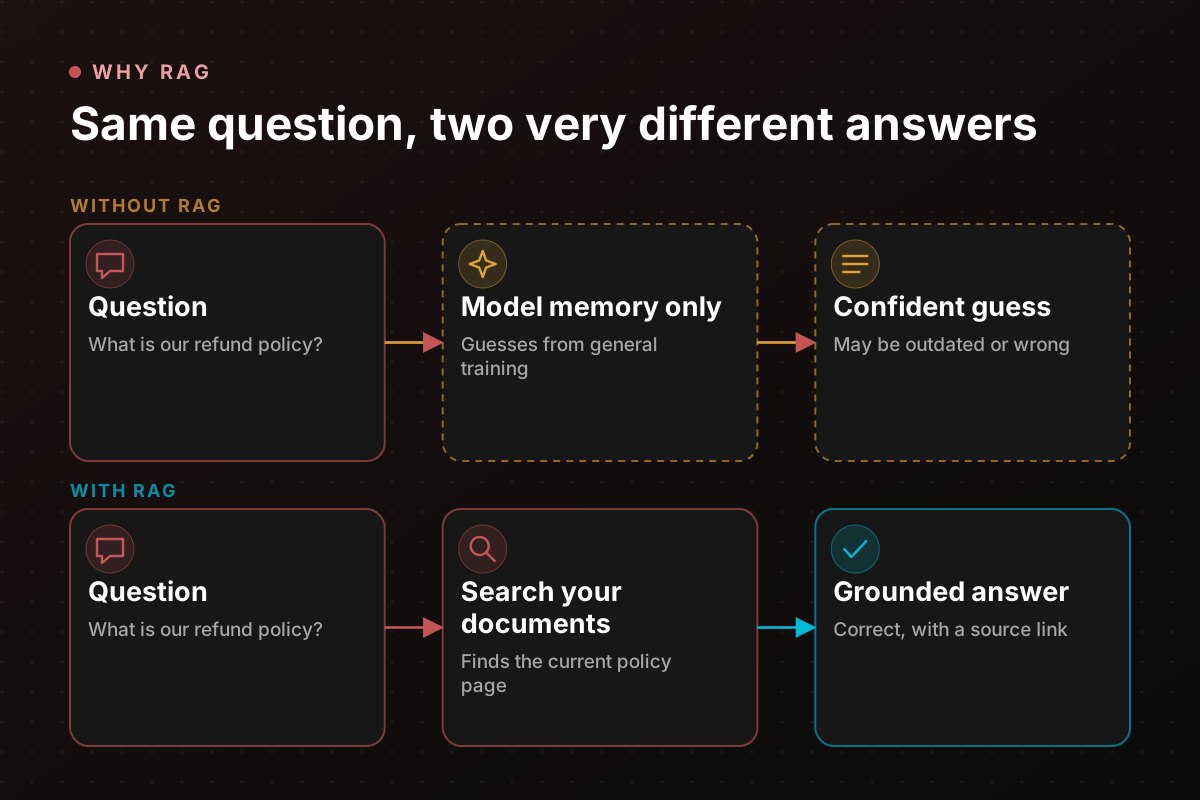
Nihai yanıt normal bir sohbet yanıtına benzeyebilir, ancak aradaki fark önemlidir. Normal bir chatbot, eğitiminden yola çıkarak tahmin yürütür. Bir RAG sistemi ise kendi bilgilerinizden gelen kanıtlarla yanıt verir.
RAG yetenekleri bir bakışta
| Yetenek | Ne yapar | Neden önemli |
|---|---|---|
| Belge alımı | Dosyalardan, web sitelerinden, CRM'lerden, sürücülerden ve veritabanlarından içerik çeker | Sistemi bilginin zaten bulunduğu yerlere bağlı tutar |
| Chunking | İçeriği faydalı pasajlara böler | Prompt'a tüm belgeleri doldurmak yerine geri getirmeyi hassas hale getirir |
| Metadata | Departman, tarih, müşteri, bölge ve erişim düzeyi gibi etiketler ekler | Filtrelemeyi, gizliliği ve alakayı iyileştirir |
| Vektör arama | Benzer anlama sahip pasajları bulur | Kelimeler birebir eşleşmese bile doğal soruları ele alır |
| Anahtar kelime araması | Kesin adları, ID'leri ve ifadeleri bulur | Anlamsal aramanın kesin terimleri kaçırmasını önler |
| Yeniden sıralama (reranking) | İlk aramanın ardından sonuçları yeniden sıralar | En iyi kanıtı en üste taşır |
| Prompt oluşturma | Talimatları, getirilen bağlamı ve kullanıcı sorusunu birleştirir | Modelin nasıl yanıt vereceğini kontrol eder |
| Kaynak gösterimi | Yanıtın nereden geldiğini gösterir | Güven oluşturur ve kullanıcıların yanıtı doğrulamasına yardımcı olur |
| Değerlendirme | Geri getirme ve yanıt doğruluğunu test eder | Sistemin gelişip gelişmediğini veya kayıp yaşayıp yaşamadığını gösterir |
Bir RAG pipeline'ı nasıl çalışır?
Pratik bir RAG iş akışı, sisteme yeni içerik girdiğinde başlar. Bu içerik bir editör tarafından yüklenmiş, GitHub'dan çekilmiş, Google Drive'dan senkronize edilmiş, bir yardım masasından okunmuş veya bir veritabanından alınmış olabilir.
Veri alım işi içeriği temizler, tekrar eden gezinme metinlerini kaldırır, faydalı yapıyı çıkarır ve materyali chunk'lara böler. Her chunk, hassas biçimde geri getirilebilecek kadar küçük, ancak anlamı koruyacak kadar büyük olmalıdır.
Sonra sistem embedding'leri oluşturur. Embedding, bir pasajın anlamının sayısal bir temsilidir. Benzer fikirler vektör uzayında birbirine yakın yerleşir; bu sayede "teslimat başarısızlığı sonrası iade" ile ilgili bir soru, "kaçırılan gönderi için değişim veya geri ödeme" diyen bir politikayı bulabilir.
Kullanıcı bir soru sorduğunda sistem soruyu embedding'e çevirir, vektör veritabanında arama yapar, filtreleri uygular, isteğe bağlı olarak sonuçları yeniden sıralar ve en güçlü kanıtı modele gönderir. Model ardından yanıtı yazar ve kullandığı kaynakları belirtir.
Geri getirme, fine tuning ve arama karşılaştırması
RAG, fine tuning ile aynı şey değildir. Fine tuning, bir modelin nasıl davrandığını değiştirir. RAG ise modelin yanıt anında hangi bilgiyi gördüğünü değiştirir.
Bilgi sık değiştiğinde, gizli kalması gerektiğinde, kaynak gösterimi gerektirdiğinde veya belirli bir müşteriye, ürüne ya da ekibe ait olduğunda RAG kullanın. Modelin tekrarlayan bir üslubu izlemesi, bir şeyi tutarlı biçimde sınıflandırması veya canlı belgelere bağlı olmayan dar bir görev örüntüsünü öğrenmesi gerektiğinde fine tuning kullanın.
Geleneksel arama hâlâ önemlidir. Birçok iş sisteminde kesin adlar, fatura numaraları, SKU'lar, talep ID'leri ve hukuki terimler anahtar kelime eşleşmesi gerektirir. En güçlü RAG sistemleri genellikle tek bir yönteme güvenmek yerine anahtar kelime aramasını, vektör aramayı, filtreleri ve yeniden sıralamayı birleştirir.
Veri hazırlığı
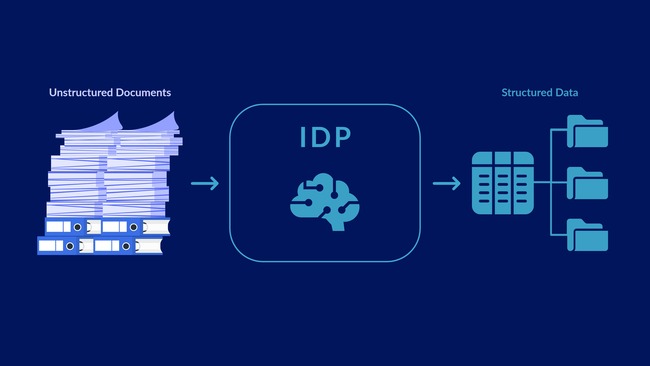
Bir RAG yanıtının kalitesi, model herhangi bir şey görmeden önce başlar. Kaynak belgeler kopya, güncelliğini yitirmiş, eksik veya kötü biçimlendirilmişse, pipeline karışıklığı geri getirir.
İyi bir hazırlık; her sayfada tekrar eden üst ve alt bilgileri kaldırır, tabloları korur, bölüm başlıklarını açıkladıkları paragraflarla birlikte tutar ve özgün kaynak bağlantısını saklar. PDF'lerde OCR kalitesi önemlidir. Web sitelerinde gezinme öğeleri ve çerez bannerları kaldırılmalıdır. Elektronik tablolarda sütun adları satırlarla birlikte taşınmalıdır.
Sürümleme de önemlidir. Bir politika geçen ay değiştiyse, sistem hangi sürümün güncel olduğunu bilmelidir. Eski bir belgenin denetim nedenleriyle erişilebilir kalması gerekiyorsa, canlı yanıtla yarışmak yerine arşivlenmiş olarak işaretlenmelidir.
Chunking ve metadata
Chunking basit görünür, ancak kaliteyi etkileyen en büyük kaldıraçlardan biridir. Her 500 karakterde bir bölmek genellikle bağlamı bozar. Başlığa, paragrafa, tabloya veya mantıksal birime göre bölmek modele daha iyi materyal sağlar.
Metadata, geri getirmeyi geniş bir aramadan kontrollü bir aramaya dönüştürür. Bir destek ajanı yalnızca finansa özel materyali görmemelidir. Müşteriye yönelik bir yanıt, şirket içi bir taslağı kullanmamalıdır. Bir satış asistanının yalnızca herkese açık vaka çalışmalarına ve onaylı satış dili metinlerine ihtiyacı olabilir.
Faydalı metadata genellikle içerik türünü, departmanı, sahibi, güncellenme tarihini, müşteriyi, ürün hattını, bölgeyi, izinleri ve yaşam döngüsü durumunu içerir. İyi metadata ile sistem, "Birleşik Krallık'taki kurumsal iade politikamız nedir?" sorusunu eski ABD küçük işletme koşullarını karıştırmadan yanıtlayabilir.
Embedding'ler ve vektör veritabanları
Embedding'ler anlamsal aramayı mümkün kılar. Embedding modeli her chunk'ı bir vektöre dönüştürür ve vektör veritabanı bu vektörleri hızlı benzerlik araması için saklar.
Veritabanı seçimi; ölçeğe, gecikmeye, barındırma tercihine ve mevcut altyapıya bağlıdır. Daha küçük projeler yönetilen hizmetlerle veya bir Postgres eklentisiyle başlayabilir. Daha büyük sistemler hibrit arama, metadata filtreleri ve yüksek erişilebilirlik sunan özel bir vektör veritabanı kullanabilir.
Model seçimi de önemlidir, ancak sihirli değildir. Daha iyi embedding'ler yardımcı olur, fakat dağınık içeriği kurtaramaz. Makul bir embedding modeliyle temiz bir bilgi tabanı, genellikle en yeni modelle kaotik bir bilgi tabanını geride bırakır.
Geri getirme kalitesi
Geri getirme kalitesi basit bir soru sorar: pipeline doğru kanıtı getirdi mi? Cevap hayırsa, yanıtı hangi dil modeli yazarsa yazsın nihai yanıt zorlanır.
Ekipler geri getirmeyi gerçek sorularla test etmelidir. Her soru için ideal kaynak pasajları işaretleyin. Ardından aramanın bu pasajları üst sonuçlarda getirip getirmediğini ölçün. Bu, chunking'i, metadata'yı, filtreleri, sorgu yeniden yazımını ve yeniden sıralamayı iyileştirmek için somut bir yol sağlar.
Geri getirme ayrıca "bilmiyorum" diyebilmeyi de desteklemelidir. Güçlü bir kanıt bulunamazsa en iyi yanıt çoğu zaman güvenli bir ret ya da daha fazla bağlam talebidir. Kanıtsız, kendinden emin bir yanıt, RAG'ın önlemesi gereken hata biçimidir.
Prompt oluşturma ve kaynak gösterimi
Prompt oluşturma, sistemin modele getirilen bağlamı nasıl kullanacağını söylediği yerdir. Talimat kuralı net ortaya koymalıdır: yalnızca verilen kaynaklardan yanıt ver, kaynakları göster ve kaynaklar yeterli bilgi içermediğinde bunu söyle.
Kaynak göstermek süs değildir. Bir destek ajanının, yöneticinin veya müşterinin yanıtı kontrol etmesini sağlar. Ayrıca hata ayıklamayı kolaylaştırır; çünkü ekip, yanıtın yanlış kaynaktan mı geldiğini yoksa doğru kaynağın kötü yazılmış mı olduğunu görebilir.
İş kullanımında kaynak gösterimleri mümkün olduğunda özgün sayfaya, belgeye, talebe veya kayda işaret etmelidir. Kullanıcı kaynağı açamıyorsa, kaynak gösterimi daha az işe yarar.
Güvenlik ve izinler
RAG sistemleri erişim kurallarına uymalıdır. Bir çalışan bir belgeyi doğrudan açamıyorsa, yapay zeka bunu üretilen bir yanıt aracılığıyla ifşa etmemelidir.
Bu, izin duyarlı bir geri getirme gerektirir. Sistem sonuçları yanıt yazıldıktan sonra değil, model görmeden önce filtrelemelidir. Ayrıca hangi kaynakların kullanıldığını, soruyu kimin sorduğunu ve hangi izin filtresinin uygulandığını loglamalıdır.
Özel müşteri verileri ekstra dikkat gerektirir. Çok kiracılı (multi-tenant) bir sistem, bir müşterinin materyalinin başka bir müşterinin yanıtında görünmesine asla izin vermemelidir. En güvenli tasarım, müşteri sınırlarını metadata'da açıkça tutar ve lansmandan önce sızıntıları test eder.
Değerlendirme
RAG değerlendirmesi, geri getirmeyi üretimden ayırmalıdır. Geri getirme testleri doğru kaynakların bulunup bulunmadığını sorar. Üretim testleri ise nihai yanıtın doğru, eksiksiz, anlaşılır ve düzgün kaynak gösterilmiş olup olmadığını sorar.
Faydalı bir test seti; yaygın soruları, uç durumları, yanıtı olmayan soruları ve kolayca karıştırılabilen soruları içerir. Örneğin "Onboarding sonrası iptal edebilir miyim?" sorusunun yanıtı aylık, yıllık, kurumsal ve deneme müşterileri için farklı olabilir.
İnsan incelemesi hâlâ önemlidir. Konu uzmanlarının yanıtlardan bir örneklemi derecelendirmesine izin verin. Sorunları türüne göre takip edin: eksik kaynak, güncelliğini yitirmiş kaynak, yanlış yorum, zayıf ifade veya izin sorunu. Her kategori farklı bir çözüme işaret eder.
Maliyet ve performans
RAG maliyeti; veri alımından, depolamadan, aramadan, yeniden sıralamadan ve üretimden gelir. Sistem dikkatle tasarlanmazsa uzun prompt'lar ve tekrarlanan aramalar pahalı hale gelebilir.
En hızlı tasarruflar genellikle yaygın yanıtları önbelleğe almaktan, getirilen chunk sayısını sınırlamaktan, görev için doğru modeli seçmekten ve gereksiz yeniden sıralamadan kaçınmaktan gelir. Bazı sorular güçlü bir model gerektirir. Birçok şirket içi bilgi sorusu gerektirmez.
Performans da güveni etkiler. Yanıt çok uzun sürerse insanlar manuel aramaya geri döner. İyi bir hedef, kullanıcıya sonuca güvenmesi için yeterli kanıtı verirken birkaç saniye içinde işe yarar yanıtlar döndürmektir.
Yaygın hata örüntüleri
En yaygın RAG hatası, zayıf kaynak hijyenidir. Ekipler eski taslaklar, kopya PDF'ler ve çelişen politika sayfaları dahil sahip oldukları her dosyayı bağlar. Yapay zeka da karışıklığı yüzeye çıkarmanın daha hızlı bir yolu haline gelir.
İkinci hata, izinleri göz ardı etmektir. Bir demo herkese açık belgelerle çalışır, sonra gerçek erişim kuralları ortaya çıkınca bozulur. İzinler, son aşamada eklenen bir güvenlik yaması değil, ilk tasarımın parçası olmalıdır.
Üçüncü hata, yalnızca nihai yanıtı ölçmektir. Yanıt yanlışsa, ekibin geri getirmenin mi başarısız olduğunu, kaynağın mı yanlış olduğunu yoksa modelin kaynağı kötü mü yorumladığını bilmesi gerekir. Bu ayrım olmadan her düzeltme tahmine dönüşür.
Uygulama yol haritası
Tek bir iş akışıyla başlayın. İyi bir ilk proje bir destek bilgi asistanı, bir şirket içi politika asistanı veya bir satış enablement asistanı olabilir. Tüm departmanları aynı anda bağlamaya çalışmaktan kaçının.
Kaynak materyali haritalayın, kullanıcıları tanımlayın, neleri görmelerine izin verildiğine karar verin ve yirmi ila elli gerçek soru yazın. Pipeline'ı bu sorulara göre kurun, ardından içeriği bilen kişilerle test edin.
İlk iş akışı güvenilir hale geldiğinde, daha fazla kaynak, daha iyi geri bildirim döngüleri ve analitik ekleyerek genişletin. Amaç zekice bir demo yapmak değildir. Amaç, zaman kazandırdığı ve temellendirilmiş yanıtlar verdiği için insanların kullandığı bir sistem yaratmaktır.
RAG'ı kimler kullanmamalı?
RAG her zaman cevap değildir. İçeriğiniz küçük, sabit ve zaten kolay aranabilir durumdaysa, normal bir dokümantasyon sitesi yeterli olabilir.
Kaynak materyal güvenilir değilse RAG yine uygun bir seçim değildir. İşletme hangi politikanın doğru olduğu konusunda anlaşamıyorsa, bir yapay zeka katmanı yönetişim sorununu çözmez. Yalnızca daha hızlı ortaya çıkarır.
Son olarak, muhakeme gerektiren ancak belgelenmiş bir standardı olmayan kararlar için RAG'dan kaçının. Pipeline bilgiyi geri getirebilir, ancak şirketin henüz yazmadığı bir politikayı icat edemez.
Sonuç
RAG, genel bir dil modeline doğru bilgiyi doğru anda vererek onu daha faydalı bir iş sistemine dönüştürür. Model hâlâ önemlidir, ancak asıl iş temiz içerikte, akıllı geri getirmede, izinlerde, kaynak göstermede ve değerlendirmede yatar.
En iyi RAG projeleri dar başlar, değer kanıtlar ve dikkatle genişler. Pipeline doğru kanıtı getirdiğinde ve yanıt nereden geldiğini gösterdiğinde, ekipler yapay zekayı bir yenilik olarak görmeyi bırakıp şirket bilgisine pratik bir arayüz olarak görmeye başlar.
Sık Sorulan Sorular
RAG, modeli belgelerim üzerinde eğitir mi?
Hayır. Normal bir RAG kurulumunda belgeleriniz yanıt anında getirilir ve prompt'a iletilir. Modelin bunları kullanması için yeniden eğitilmesi gerekmez.
RAG özel belgelerle çalışabilir mi?
Evet, ancak izinlerin geri getirmenin içine yerleştirilmesi gerekir. Sistem, özel materyali modele ulaşmadan önce filtrelemelidir.
Başlamak için kaç belgeye ihtiyacım var?
Küçük, yüksek değerli bir bilgi tabanıyla başlayabilirsiniz. İlk sürüm için hacimden çok kalite önemlidir.
RAG projelerinin başarısız olmasının en büyük nedeni nedir?
Başarısızlıkların çoğu dağınık kaynak içeriğinden, zayıf metadata'dan veya değerlendirme sürecinin olmamasından kaynaklanır. Sorun nadiren yalnızca modeldir.